1. čas. Pronalaženje elemenata izvan granica
Srednja vrednost
Srednja vrednost $\mu$ promenljive je jedna od najznačajnijih osobina promenljive. Ipak, kako najčešće nije moguće izračunati srednju vrednost cele populacije, rešenje se nalazi u uzoračkoj sredini $\overline{X}$ dobijene na manjem, reprezentativnom uzorku. Uzoračka sredina predstavlja najbolju procenu srednje vrednosti. U slučaju jednodimenzione slučajne promenljive, uzoračka sredina se računa kao aritmetička sredina vrednosti dobijenih iz uzorka. $$\overline{X} = \frac{1}{n}\sum_{i = 1}^{n}{x_{i}}$$ U slučaju višedimenzionih slučajnih promenljivih, uzoračka sredina predstavlja vektor aritmetičkih sredina pojedinačnih koordinata. $$X_1 = (x_{11}, x_{12}, x_{1m})$$ $$X_2 = (x_{21}, x_{22}, x_{2m})$$ $$...$$ $$X_n = (x_{n1}, x_{n2}, x_{nm})$$ $$\overline{X} = (\overline{X_1}, \overline{X_2}, ... \overline{X_n})$$
import numpy as np
univariate_data = [1,2,3,4,5]
multivariate_data = [[1,1],
                     [2,2],
                     [3,3],
                     [4,4],
                     [5,5]]
Funkcija koja izračunava uzoračku sredinu:
def sample_mean(data):
    n = len(data)
    return sum(np.array(data)) / n

print(sample_mean(univariate_data))
sample_mean(multivariate_data)
Takođe, funkcija mean u okviru Numpy biblioteke koja izračunava uzoračku sredinu:
import numpy as np

print(np.mean(univariate_data))
print(np.mean(multivariate_data, axis=0))
Podaci u primerima biće smeštani u Pandas DataFrame objekte
import pandas as pd
Primer 1.
Neka atribut visina označava vrednosti slučajne promenljive koja predstavlja visinu osobe. Srednja vrednost promenljive aproksimira se uzoračkom sredinom.
height_data = [165.2, 171.8, 192.5, 181.3, 174.5, 146.1, 189.0, 175.3, 181.3, 167.8]
ex1_data = pd.DataFrame(data=height_data, columns=['visina'])
ex1_data.head()
mean = np.mean(ex1_data['visina'])
print(f'Srednja visina: {mean}')
Primer 2.
Neka atributi lat i lon označavaju vrednosti koordinata slučajne promenljive koja predstavlja lokaciju objekta. Srednja vrednost promenljive aproksimira se srednjom vrednošću pojedinačnih koordinata.
location_data = [[44.1231, 20.3412],
                 [44.4231, 20.3464],
                 [44.3221, 20.3433],
                 [44.7122, 20.9434]]

ex2_data = pd.DataFrame(data=location_data, columns=['lat', 'lon'])
ex2_data.head()
mean = np.mean(ex2_data[['lat','lon']], axis = 0)
print(f'Srednja lokacija: \n{mean}')
Disperzija i standardna devijacija
Udaljenost pojedinačnih vrednosti slučajne promenljive od srednje vrednosti $\mu$ populacije izražava se disperzijom i standardnom devijacijom. Disperzija $\sigma^2$ predstavlja prosečno kvadratno odstupanje od srednje vrednosti, dok je standardna devijacija $\sigma$, prosečno odstupanje od sredine, dobijeno kao koren disperzije.
Kako često nije poznata prava srednja vrednost populacije, pri računanju uzoračke disperzije $s^2$ koristi se uzoračka sredina $\overline{X}$. Pošto je uzoračka sredina dobijena korišćenjem istih $n$ vrednost pomoću kojih se računa i uzoračka disperzija, vrednost uzoračke disperzije se računa sa $n-1$ stepenom slobode.
Za računanje disperzije i standardne devijacije, mogu se koristiti funkcije var i std iz numpy biblioteke. Za zadavanje stepena slobode koristi se atribut ddof gde je broj stepena slobode jednak 1 - ddof
Primer 3.
Računanje prosečnog odstupanja visine osobe od uzoračke sredine
variance = np.var(ex1_data['visina'], ddof=1)
stdev = np.std(ex1_data['visina'], ddof=1)

print(f'Prosečno kvadratno odstupanje visine: {variance}')
print(f'Prosečno odstupanje visine: {stdev} cm')
Primer 4.
Računanje prosečnog odstupanja lokacije od uzoračke sredine
variance = np.var(ex2_data[['lat','lon']], ddof=1)
stdev = np.std(ex2_data[['lat','lon']], ddof=1)

print(f'Prosečno kvadratno odstupanje lokacije:\n{variance}')
print(f'Prosečno odstupanje lokacije:\n{stdev}')
Normalna raspodela
Jedna od najčešćih raspodela u prirodi jeste normalna raspodela. Normalna raspodela se definiše parametrima populacije srednje vrednosti i standardne devijacije. Raspodela se može aproksimirati uzoračkom sredinom i uzoračkom standardnom devijacijom. Gustina raspodele definiše se kao:
Posebno zanimljiva varijanta normalne raspodele je $\mathcal{N}(0,1)$ sa sredinom 1 i standardnom devijacijom 0, u odnosu na koju se može vršiti veliki broj testova. Ukoliko je raspodela iz koje dolazi uzorak normalna, ali ne sa parametrima (0,1), moguće je standardizovati podatke na normalnu (0,1) raspodelu računanjem Z-vrednosti.
def z_value(x, mu, sigma):
    return (x - mu) / sigma
Vrednostima funkcije raspodele i funkcije gustine raspodele mogu se dobiti korišćenjem funkcija cdf i pdf iz biblioteke scipy.stats.norm
from scipy.stats import norm
print(norm.cdf(0))
print(norm.pdf(0))
Centralna granična teorema
Srednja vrednost uzoraka dobijenih iz populacije sa određenom raspodelom ima normalnu raspodelu sa sredinom u istoj vrednosti kao i raspodela populacije
Primer 5.
Iz uniformne raspodele sa granicama 0 i 10 uzima se 10000 slučajno odabranih vrednosti i to 1000 puta po 10 uzoraka. Srednja vrednost navedene uniformne raspodele se nalazi u tački 5. Nakon desete iteracije, raspodela srednjih vrednosti dobijenih u svakoj od iteracija ima normalnu raspodelu sa sredinom baš u tački 5.
import random
import matplotlib.pyplot as plt

means = []
total_samples = []

a = 0
b = 10
iterations = 1000
num_samples = 10

for _ in range(iterations):
    samples = []
    for _ in range(num_samples):
        samples.append(random.randrange(a, b))
    total_samples += samples
    means.append(np.mean(samples))
Raspodela vrednosti uzoraka:
_ = plt.hist(total_samples)

_ = plt.hist(means)

mean = np.mean(means)
stdev = np.std(means, ddof = 1)

X_norm = np.linspace(a,b)
y_norm = norm.pdf(X_norm, mean, stdev) * (1 / norm.pdf(0) * iterations/4) # Mnozenje samo radi skaliranja
plt.plot(X_norm, y_norm)
plt.show()

Utvrđivanje normalnosti
Da bi se utvrdilo da je raspodela vrednosti normalna, može se koristiti Šapiro-Vilk test (Shapiro-Wilk). Rezultat testa daje $p$-vrednost koja govori o značajnosti odstupanja od normalne raspodele. Za prag značajnosti se može odrediti vrednost $\alpha = 0.05$. Ukoliko je rezultujuća $p$-vrednost niža od $\alpha$, može se smatrati da podaci ne dolaze iz normalne raspodele
Funkcija shapiro iz biblioteke scipy.stats za prosleđeni skup vrednosti kao povratnu vrednost vraća vrednost testa $W$ kao i $p$-vrednost na osnovu koje se može doneti odluka o odbacivanju hipoteze koja tvrdi da podaci dolaze iz normalne raspodele.
from scipy.stats import shapiro

sample_data = [0,0,1,23,6,34,89,56,80,80,90]
plt.hist(sample_data)

(W, p) = shapiro(sample_data)
print(f'p-vrednost dobijena Shapiro-Wilk testom: {p}')

Kako je rezultujuća vrednost manja od $\alpha = 0.05$, odbacuje se hipoteza da podaci dolaze iz normalne raspodele. Ovaj test se može formulisati kao funkcija čija povratna vrednost vraća true ili false u zavisnosti od toga da li rezultati testa govore o tome da podaci dolaze iz normalne raspodele ili ne.
def is_normal_dist(data, alpha = 0.05):
    (W, p) = shapiro(data)
    return p >= alpha
alpha = 0.05
is_normal_dist(sample_data, alpha)
normal_data = [0,1,2,2,3,3,3,3,4,4,4,4,4,5,5,5,5,6,6,7,8]
_ = plt.hist(normal_data)

is_normal_dist(normal_data, alpha)
Detekcija elemenata izvan granica
Elementi izvan granica (eng outliers) su elementi koji značajno odstupaju po vrednostima od ostatka populacije ili skupa. Takvi elementi mogu se tumačiti na različite načine, kao neispravni podaci ili šum koji treba ukloniti ili kao vrednosti koje su posebno zanimljive jer otkrivaju neke skrivene, retko uočljive procese, a koje treba sačuvati i dodatno analizirati.
Ukoliko je poznata raspodela iz koje podaci dolaze, moguće je utvrditi koliko je pojava svake od vrednosti verovatna u odnosu na raspodelu. Ukoliko je verovatnoća pojave vrednosti niža od zadatog praga, vrednost se može proglasiti outlier-om.
Z-Skor
Kao što je prethodno već pomenuto, vrednosti koje dolaze iz normalne raspodele koja nije (0,1) mogu se standardizovati na vrednosti iz normalnu (0,1) u obliku Z-vrednosti. Površina ispod grafika gustine raspodele od Z vrednosti ka beskonačnosti definiše verovatnoću pojava elementa u raspodeli.
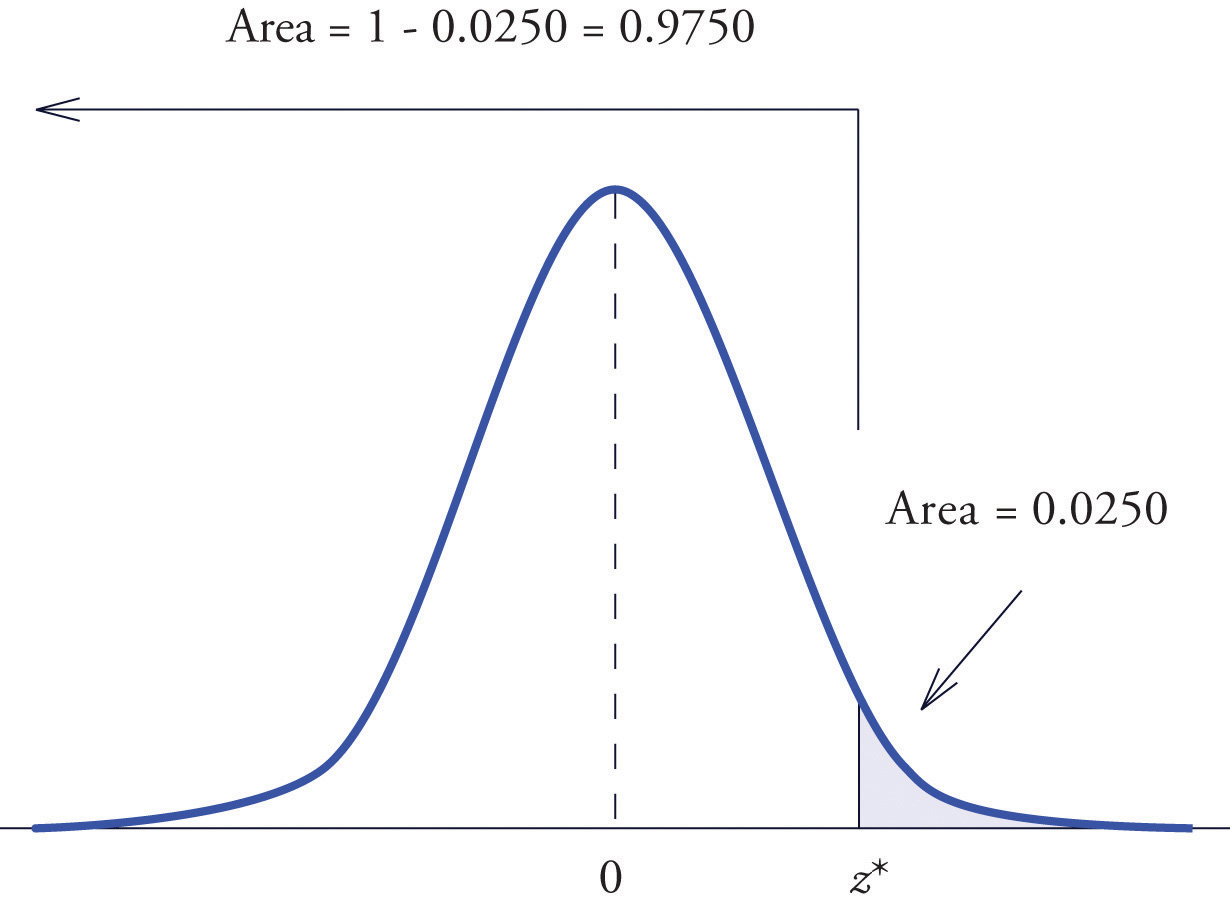
Apsolutna vrednost Z skora predstavlja udaljenost vrednosti elementa od sredine raspodele u standardnim devijacijama. Da bi se element proglasio outlier-om, verovatnoća njegove pojave treba biti manja od određenog praga. Prag se može izraziti i na drugi način, kao granica udaljenosti vrednosti od sredine raspodele preko koje se element proglašava outlier-om. Za prag udaljenosti se obično uzima vrednost od 3 standardne devijacije, za koju se vezuje verovatnoća ~0.99. Kako normalna (0,1) raspodela ima standardnu devijaciju jednaku jedinici, to je Z vrednost 3 upravo odstupanje od 3 standardne devijacije, pa se outlier-ima mogu proglasiti sve vrednosti cije su apsolutne Z vrednosti veće od 3.
Prednosti algoritma:
- Jednostavnost
- Brzina
- Dobra zasnovanost u statistici
Mane algoritma:
- Radi samo za jednodimenzinalne promenljive
- Potrebno poznavanje raspodele iz koje podaci dolaze
def z_score_outlier(x, mu, sigma, threshold = 3):
    z = z_value(x, mu, sigma)
    return abs(z) > threshold
Primer 6.
Detekcija outlier-a korišćenjem Z-skora.
normal_data_with_outlier = [2.00,
                            4.10,
                            1.60,
                            1.10,
                            2.20,
                             1.20e+1,
                             7.30e+0,
                            -2.50e+1,
                             1.50e+1,
                            -1.20e+1,
                            -4.70e+0,
                             2.10e+1,
                             1.80e+0,
                             2.30e+1,
                            -8.90e+0,
                             1.90e+0,
                             2.00e+1,
                            -1.00e+1,
                            -1.10e+1,
                            -1.90e+1,
                             1.70e+1,
                             7.90e+0,
                             2.90e+1,
                             1.10e+1,
                            -1.70e+1,
                             1.40e-1,
                             6.20e+0,
                             7.10e+0,
                             1.20e+1,
                             3.60e+0,
                            55
                           ]
np.random.shuffle(normal_data_with_outlier)
num_elements = len(normal_data_with_outlier)
plt.scatter([i for i in range(num_elements)],normal_data_with_outlier)

_ = plt.hist(normal_data_with_outlier)

_ = plt.boxplot(normal_data_with_outlier)

Kako vrednost 3, odabrana za graničnu vrednost pri označavanju outlier-a, važi samo u slučaju normalne raspodele, potrebno je proveriti da li podaci prate normalnu raspodelu!
def z_score_outliers(data):
    outliers = []
    if is_normal_dist(data, 0.05):
        mean = np.mean(data)
        stdev = np.std(data, ddof=1)

        for el in data:
            if z_score_outlier(el, mean, stdev, 3):
                outliers.append(el)

        return outliers
    else:
        print('Non-normal distribution!')
outliers = z_score_outliers(normal_data_with_outlier)
plt.scatter([i for i in range(num_elements)],normal_data_with_outlier)
plt.scatter([normal_data_with_outlier.index(x) for x in outliers], outliers)
print(f'Outliers: {outliers}')

Pronalaženje elemenata izvan granica u multivarijantnim raspodelama
Z-skor je test koji važi u slučaju jednodimenzionalnih promenljivih. Uopštenje Z-skora na višedimenzionalne promenljive je Mahalanobisovo rastojanje koje predstavlja rastojanje između vrednosti i sredine raspodele izraženo, u standardnim devijacijama.
Gde je $\vec{\mu}$ srednja vrednost višedimenzione promenljive a $S$ matrica kovarijanse uzorka.
Mahalanobisovo rastojanje primenjeno na jednodimenzionalne promenljive daje iste rezultate kao i Z-skor. Kako vrednost $D_M^2$ prati $\chi^2$ raspodelu, u slučaju višedimenzionalnih promenljivih vrednost praga preko koga se vrednost smatra outlier-om definiše se vrednostima iz $\chi^2$ raspodele sa $n$ stepena slobode, gde je $n$ broj dimenzija promenljive
Funkcija za računanje Mahalanobisovog rastojanja nalazi se u biblioteci scipy.spatial.distance
from scipy.spatial.distance import mahalanobis
Primer 7.
Računanje mahalanobisovog rastojanja na jednodimenzionalnoj slučajnoj promenljivoj.
mean = np.mean(normal_data_with_outlier)
stdev = np.std(normal_data_with_outlier, ddof=1)

x = [50]

z_score = z_value(x, mean, stdev)[0]

S = np.matrix(np.cov(normal_data_with_outlier))
S_inv = np.linalg.pinv(S)

mean_vector = [mean]

md = mahalanobis(x, mean_vector, S_inv)[0,0]

print(f'Z-skor: {z_score}')
print(f'Mahalanobisovo rastojanje: {md}')
Vrednosti funkcije raspodele i funkcije gustine raspodele $\chi^2$ raspodele nalaze se u biblioteci scipy.stats.chi2
from scipy.stats import chi2
df = 5 # proizvoljan broj, primer
print(chi2.cdf(5, df))
print(chi2.pdf(5, df))
Primer 8.
Pronalaženje outlier-a u slučaju višedimenzionih promenljivih
def mahalanobis_outlier(x, mean_vector, S, alpha = 0.05):
    S_inv = np.linalg.pinv(S) # Pseudoinverz, u slucaju singulane matrice

    md = mahalanobis(x, mean_vector, S_inv)[0,0]**2
    df = len(x)

    return 1 - chi2.cdf(md, df) < alpha
multidimensional_data = [[3.40e+0,   2.00e+1],
                         [1.20e+1,  -5.10e+0],
                         [1.50e+1,   5.60e+1],
                         [1.10e+1,   2.60e+1],
                        [-2.10e+1,  -4.10e+0],
                        [5.70e+0,  -4.30e+1],
                         [3.30e+1,   1.50e+0],
                        [-1.90e+1,  -2.70e-1],
                         [1.40e+1,   2.10e+1],
                         [3.60e+0,  -7.40e+0],
                         [3.90e+0,   2.80e+1],
                         [2.70e+1,  -1.80e+1],
                         [1.10e+1,   2.30e+1],
                         [1.10e+1,   1.50e+1],
                         [2.00e+1,  -9.10e+0],
                         [1.80e+1,  -3.40e+1],
                         [6.80e+0,   2.80e+1],
                        [-2.40e+1,   4.70e+1],
                        [-3.00e+0,   2.30e+1],
                         [1.60e+0,   5.50e+0],
                        [-1.30e+1,  -5.80e+0],
                         [1.10e+1,   3.40e+1],
                         [5.20e+0,  -8.40e+0],
                        [-1.20e+1,  -2.30e+1],
                         [1.80e+1,  -1.20e+1],
                         [2.10e+1,  -9.70e+0],
                         [1.80e+0,   1.10e+1],
                         [1.70e+1,   1.70e+1],
                        [-1.50e+1,  -2.40e+1],
                         [2.20e+1,  -2.90e+0],
                         [65,65]
                         ]

multi_data = pd.DataFrame(data = multidimensional_data, columns = ['X1','X2'])
multi_data.head()
_ = plt.scatter(multi_data['X1'],multi_data['X2'])

is_normal_dist(multi_data[['X1','X2']])
def mahalanobis_outliers(data, alpha = 0.01):
    outliers = []
    S = np.matrix(np.cov(data.values.T))
    mean_vector = np.mean(data.values, axis = 0)

    for el in data.values:
        if mahalanobis_outlier(el, mean_vector, S, alpha):
            outliers.append(el)

    return outliers
outliers = mahalanobis_outliers(multi_data, alpha=0.01)
print(outliers)

plt.scatter(multi_data['X1'],multi_data['X2'])
_ = plt.scatter([x[0] for x in outliers], [x[1] for x in outliers])

Vežba 1. Analiza podataka iz Iris baze
Iris skup podataka (dostupan sa adrese: Iris) sadrži podatke o 150 biljaka. Podaci se sastoje od četiri atributa:
- petal.length
- petal.width
- sepal.length
- sepal.width
i oznake klase kojoj biljka pripada (variety)
Moguće klase kojoj biljka može pripadati su:
- Setosa
- Virginica
- Versicolor
iris_data = pd.read_csv('iris.csv')
iris_data.head()
Kako bi se stekao bolji uvid u osobine atributa, poželjno je nacrtati histogram raspodela pojedinačnih atributa
fig = plt.figure(figsize=(10, 10), dpi= 80)
ax1 = fig.add_subplot(221)
ax1.set_xlabel('Petal length')
ax1.set_ylabel('Frequency')
ax1.hist(iris_data['petal.length'])

ax2 = fig.add_subplot(222)
ax2.set_xlabel('Petal width')
ax2.set_ylabel('Frequency')
ax2.hist(iris_data['petal.width'])

ax3 = fig.add_subplot(223)
ax3.set_xlabel('Sepal length')
ax3.set_ylabel('Frequency')
ax3.hist(iris_data['sepal.length'])

ax4 = fig.add_subplot(224)
ax4.set_xlabel('Sepal width')
ax4.set_ylabel('Frequency')
_ = ax4.hist(iris_data['sepal.width'])

pl = iris_data['petal.length']
pw = iris_data['petal.width']
sl = iris_data['sepal.length']
sw = iris_data['sepal.width']

print('Checking normality of attribute distribution: ')
print(f'Petal length: {is_normal_dist(pl)}')
print(f'Petal width: {is_normal_dist(pw)}')
print(f'Sepal length: {is_normal_dist(sl)}')
print(f'Sepal width: {is_normal_dist(sw)}')
Iz histograma atributa mogu se zaključiti korisne informacije o skupu. Kako tri od četiri atributa nemaju normalnu raspodelu, jasno se može zaključiti da su podaci nastali kao rezultat više procesa te da postoji više klasa (što nam klasni atribut variety i potvrđuje). Da je reč o tri klase, govori u prilog broj moda u raspodelama sepal.length, petal.width a dobrim delom i petal.length Iz normalne raspodele atributa sepal.width zaključuje se da se vrednosti atributa ne razlikuju u zavisnosti od klasa te da atribut neće doprinet pri klasifikaciji podataka.
setosa_data = iris_data[iris_data.variety == 'Setosa']
virginica_data = iris_data[iris_data.variety == 'Virginica']
versicolor_data = iris_data[iris_data.variety == 'Versicolor']

fig = plt.figure(figsize=(10, 10), dpi= 80)

ax1 = fig.add_subplot(221)
ax1.set_xlabel('Petal length')
ax1.set_ylabel('Frequency')
ax1.scatter(['setosa' for x in setosa_data.values], setosa_data['petal.length'].values)
ax1.scatter(['virginica' for x in virginica_data.values], virginica_data['petal.length'].values)
ax1.scatter(['versicolor' for x in versicolor_data.values], versicolor_data['petal.length'].values)

ax1 = fig.add_subplot(222)
ax1.set_xlabel('Petal width')
ax1.set_ylabel('Frequency')
ax1.scatter(['setosa' for x in setosa_data.values], setosa_data['petal.width'].values)
ax1.scatter(['virginica' for x in virginica_data.values], virginica_data['petal.width'].values)
ax1.scatter(['versicolor' for x in versicolor_data.values], versicolor_data['petal.width'].values)

ax1 = fig.add_subplot(223)
ax1.set_xlabel('Sepal length')
ax1.set_ylabel('Frequency')
ax1.scatter(['setosa' for x in setosa_data.values], setosa_data['sepal.length'].values)
ax1.scatter(['virginica' for x in virginica_data.values], virginica_data['sepal.length'].values)
ax1.scatter(['versicolor' for x in versicolor_data.values], versicolor_data['sepal.length'].values)

ax1 = fig.add_subplot(224)
ax1.set_xlabel('Sepal width')
ax1.set_ylabel('Frequency')
ax1.scatter(['setosa' for x in setosa_data.values], setosa_data['sepal.width'].values)
ax1.scatter(['virginica' for x in virginica_data.values], virginica_data['sepal.width'].values)
_ = ax1.scatter(['versicolor' for x in versicolor_data.values], versicolor_data['sepal.width'].values)

print('Checking normality of attributes by class:')
print()
print('Setosa')
print('======')
print()
print(f'Petal length: {is_normal_dist(setosa_data["petal.length"])}')
print(f'Petal width: {is_normal_dist(setosa_data["petal.width"])}')
print(f'Sepal length: {is_normal_dist(setosa_data["sepal.length"])}')
print(f'Sepal width: {is_normal_dist(setosa_data["sepal.width"])}')
print()
print('Virginica')
print('=========')
print(f'Petal length: {is_normal_dist(virginica_data["petal.length"])}')
print(f'Petal width: {is_normal_dist(virginica_data["petal.width"])}')
print(f'Sepal length: {is_normal_dist(virginica_data["sepal.length"])}')
print(f'Sepal width: {is_normal_dist(virginica_data["sepal.width"])}')
print()
print('Versicolor')
print('=========')
print(f'Petal length: {is_normal_dist(versicolor_data["petal.length"])}')
print(f'Petal width: {is_normal_dist(versicolor_data["petal.width"])}')
print(f'Sepal length: {is_normal_dist(versicolor_data["sepal.length"])}')
print(f'Sepal width: {is_normal_dist(versicolor_data["sepal.width"])}')
Skoro svi atributi, filtrirani prema klasama, imaju normalnu raspodelu osim petal.width atributa koji ne prolazi test normalnosti u slučaju klasa Setosa i Versicolor
pw_setosa = setosa_data["petal.width"]
pw_setosa_mean = np.mean(pw_setosa)
pw_setosa_stdev = np.std(pw_setosa, ddof = 1)

plt.hist(setosa_data["petal.width"])
X = np.linspace(0,0.6,100)
y = norm.pdf(X, pw_setosa_mean, pw_setosa_stdev) * 8
_ = plt.plot(X,y)

from scipy.stats import skew
print(f'Petal width skewness for Setosa class: {skew(np.sqrt(setosa_data["petal.width"]))}')
Iz raspodele atributa petal.width pri klasi Setosa može se zaključiti da raspodela zaista ima oblik "zvona" normalne raspodele, ali da je pod nagibom (eng skewness) i to pozitivnim (desni rep raspodele je izdužen), te da ne postoje dodatni skriveni procesi koji generišu podatke.
pw_versicolor = versicolor_data["petal.width"]
pw_versicolor_mean = np.mean(pw_versicolor)
pw_versicolor_stdev = np.std(pw_versicolor, ddof = 1)

plt.hist(pw_versicolor)

X = np.linspace(0.75,2,100)
y = norm.pdf(X, pw_versicolor_mean, pw_versicolor_stdev) * 7
_ = plt.plot(X,y)

print(f'Petal width skewness for Versicolor class: {skew(versicolor_data["petal.width"])}')
print(f'Number of elements in Versicolor class: {versicolor_data.shape[0]}')
Raspodela atributa petal.width pri klasi Versicolor većim delom prati "zvono" normalne raspodele, ali zbog postojanja dve dodatne mode ne prolazi test normalnosti. Objašnjenje ove pojave može se tražiti u postojanju dodatnih, nepoznatih, podklasa u okviru Versicolor klase, ali i u činjenici da su takve nepravilnosti moguće na manjem broju podataka (u ovom slučaju 50). Nagib raspodele od -0.03 nije značajno odstupanje od centriranosti normalne raspodele.
Nalaženje elemenata izvan granica u Iris skupu
Kako su u pitanju slučajne promenljive (biljke) sa više dimenzija (4) za pronalaženje outlier-a biće korišćeno Mahalanobisovo rastojanje. Element jedne klase može biti smatran za outlier u odnosu na elemente iz druge klase, pa se pri postojanju više klasa pronalaženje outlier-a vrši pojedinačno za elemente svake od klasa.
print('alpha = 0.01')
print('============')
print()

setosa_outliers = mahalanobis_outliers(setosa_data[['petal.length', 'petal.width', 'sepal.length', 'sepal.width']])
print(f'Outliers in setosa class: {setosa_outliers}')

virginica_outliers = mahalanobis_outliers(virginica_data[['petal.length', 'petal.width', 'sepal.length', 'sepal.width']])
print(f'Outliers in Virginica class: {setosa_outliers}')

versicolor_outliers = mahalanobis_outliers(versicolor_data[['petal.length', 'petal.width', 'sepal.length', 'sepal.width']])
print(f'Outliers in setoVersicolorsa class: {versicolor_outliers}')
Iz dobijenih rezultata, može se zaključiti da Iris skup ne sadrži outlier-e u odnosu na prag $\alpha = 0.01$ (verovatnoća 0.99)
Ponovljena analiza sa nešto višim pragom $\alpha = 0.02$ (verovatnoća 0.98)
print('alpha = 0.02')
print('============')
print()

alpha = 0.02
setosa_outliers = mahalanobis_outliers(setosa_data[['petal.length', 'petal.width', 'sepal.length', 'sepal.width']], alpha)
print(f'Outliers in setosa class:')
for outlier in setosa_outliers:
    print(outlier)

print()

virginica_outliers = mahalanobis_outliers(virginica_data[['petal.length', 'petal.width', 'sepal.length', 'sepal.width']], alpha)
print(f'Outliers in Virginica class:')
for outlier in virginica_outliers:
    print(outlier)

print()

versicolor_outliers = mahalanobis_outliers(versicolor_data[['petal.length', 'petal.width', 'sepal.length', 'sepal.width']], alpha)
print(f'Outliers in Versicolor class:')
for outlier in versicolor_outliers:
    print(outlier)
U odnosu na prag $\alpha = 0.02$ Iris skup sadrži 4 outlier-a, koji analizom pojedinačnih atributa ne bi bili prepoznati
setosa_data = iris_data[iris_data.variety == 'Setosa']
virginica_data = iris_data[iris_data.variety == 'Virginica']
versicolor_data = iris_data[iris_data.variety == 'Versicolor']

fig = plt.figure(figsize=(10, 10), dpi= 80)

ax1 = fig.add_subplot(221)
ax1.set_xlabel('Petal length')
ax1.set_ylabel('Frequency')
ax1.scatter(['setosa' for x in setosa_data.values], setosa_data['petal.length'].values)
ax1.scatter(['virginica' for x in virginica_data.values], virginica_data['petal.length'].values)
ax1.scatter(['versicolor' for x in versicolor_data.values], versicolor_data['petal.length'].values)

ax1.scatter(['setosa' for x in setosa_outliers], [x[0] for x in setosa_outliers], color='red')
ax1.scatter(['virginica' for x in virginica_outliers], [x[0] for x in virginica_outliers], color='red')
ax1.scatter(['versicolor' for x in versicolor_outliers], [x[0] for x in versicolor_outliers], color='red')

ax1 = fig.add_subplot(222)
ax1.set_xlabel('Petal width')
ax1.set_ylabel('Frequency')
ax1.scatter(['setosa' for x in setosa_data.values], setosa_data['petal.width'].values)
ax1.scatter(['virginica' for x in virginica_data.values], virginica_data['petal.width'].values)
ax1.scatter(['versicolor' for x in versicolor_data.values], versicolor_data['petal.width'].values)

ax1.scatter(['setosa' for x in setosa_outliers], [x[1] for x in setosa_outliers], color='red')
ax1.scatter(['virginica' for x in virginica_outliers], [x[1] for x in virginica_outliers], color='red')
ax1.scatter(['versicolor' for x in versicolor_outliers], [x[1] for x in versicolor_outliers], color='red')

ax1 = fig.add_subplot(223)
ax1.set_xlabel('Sepal length')
ax1.set_ylabel('Frequency')
ax1.scatter(['setosa' for x in setosa_data.values], setosa_data['sepal.length'].values)
ax1.scatter(['virginica' for x in virginica_data.values], virginica_data['sepal.length'].values)
ax1.scatter(['versicolor' for x in versicolor_data.values], versicolor_data['sepal.length'].values)

ax1.scatter(['setosa' for x in setosa_outliers], [x[2] for x in setosa_outliers], color='red')
ax1.scatter(['virginica' for x in virginica_outliers], [x[2] for x in virginica_outliers], color='red')
ax1.scatter(['versicolor' for x in versicolor_outliers], [x[2] for x in versicolor_outliers], color='red')

ax1 = fig.add_subplot(224)
ax1.set_xlabel('Sepal width')
ax1.set_ylabel('Frequency')
ax1.scatter(['setosa' for x in setosa_data.values], setosa_data['sepal.width'].values)
ax1.scatter(['virginica' for x in virginica_data.values], virginica_data['sepal.width'].values)
ax1.scatter(['versicolor' for x in versicolor_data.values], versicolor_data['sepal.width'].values)

ax1.scatter(['setosa' for x in setosa_outliers], [x[3] for x in setosa_outliers], color='red')
ax1.scatter(['virginica' for x in virginica_outliers], [x[3] for x in virginica_outliers], color='red')
_ = ax1.scatter(['versicolor' for x in versicolor_outliers], [x[3] for x in versicolor_outliers], color='red')

Kako nije moguće vizualizovati podatke sa četiri dimenzije, moguće je prikazati grafike parova atributa
pl_setosa = setosa_data['petal.length']
pl_virginica = virginica_data['petal.length']
pl_versicolor = versicolor_data['petal.length']

pw_setosa = setosa_data['petal.width']
pw_virginica = virginica_data['petal.width']
pw_versicolor = versicolor_data['petal.width']

sl_setosa = setosa_data['sepal.length']
sl_virginica = virginica_data['sepal.length']
sl_versicolor = versicolor_data['sepal.length']

sw_setosa = setosa_data['sepal.width']
sw_virginica = virginica_data['sepal.width']
sw_versicolor = versicolor_data['sepal.width']


fig = plt.figure(figsize=(15, 20), dpi=80)
ax1 = fig.add_subplot(331)
ax1.set_xlabel('Petal length (Setosa)')
ax1.set_ylabel('Petal width (Setosa)')
ax1.scatter(pl_setosa, pw_setosa)
ax1.scatter([x[0] for x in setosa_outliers], [x[1] for x in setosa_outliers], color="red")

ax2 = fig.add_subplot(332)
ax2.set_xlabel('Petal length (Virginica)')
ax2.set_ylabel('Petal width (Virginica)')
ax2.scatter(pl_virginica, pw_virginica)
ax2.scatter([x[0] for x in virginica_outliers], [x[1] for x in virginica_outliers], color="red")

ax3 = fig.add_subplot(333)
ax3.set_xlabel('Petal length (Versicolor)')
ax3.set_ylabel('Petal width (Versicolor)')
ax3.scatter(pl_versicolor, pw_versicolor)
ax3.scatter([x[0] for x in versicolor_outliers], [x[1] for x in versicolor_outliers], color="red")


ax4 = fig.add_subplot(334)
ax4.set_xlabel('Petal length (Setosa)')
ax4.set_ylabel('Sepal length (Setosa)')
ax4.scatter(pl_setosa, sl_setosa)
ax4.scatter([x[0] for x in setosa_outliers], [x[2] for x in setosa_outliers], color="red")

ax5 = fig.add_subplot(335)
ax5.set_xlabel('Petal length (Virginica)')
ax5.set_ylabel('Sepal length (Virginica)')
ax5.scatter(pl_virginica, sl_virginica)
ax5.scatter([x[0] for x in virginica_outliers], [x[2] for x in virginica_outliers], color="red")

ax6 = fig.add_subplot(336)
ax6.set_xlabel('Petal length (Versicolor)')
ax6.set_ylabel('Sepal length (Versicolor)')
ax6.scatter(pl_versicolor, sl_versicolor)
ax6.scatter([x[0] for x in versicolor_outliers], [x[2] for x in versicolor_outliers], color="red")


ax7 = fig.add_subplot(337)
ax7.set_xlabel('Petal length (Setosa)')
ax7.set_ylabel('Sepal width (Setosa)')
ax7.scatter(pl_setosa, sw_setosa)
ax7.scatter([x[0] for x in setosa_outliers], [x[3] for x in setosa_outliers], color="red")

ax8 = fig.add_subplot(338)
ax8.set_xlabel('Petal length (Virginica)')
ax8.set_ylabel('Sepal width (Virginica)')
ax8.scatter(pl_virginica, sw_virginica)
ax8.scatter([x[0] for x in virginica_outliers], [x[3] for x in virginica_outliers], color="red")

ax9 = fig.add_subplot(339)
ax9.set_xlabel('Petal length (Versicolor)')
ax9.set_ylabel('Sepal width (Versicolor)')
ax9.scatter(pl_versicolor, sw_versicolor)
_ = ax9.scatter([x[0] for x in versicolor_outliers], [x[3] for x in versicolor_outliers], color="red")

fig = plt.figure(figsize=(15, 20), dpi=80)

ax1 = fig.add_subplot(331)
ax1.set_xlabel('Petal width (Setosa)')
ax1.set_ylabel('Sepal length (Setosa)')
ax1.scatter(pw_setosa, sl_setosa)
ax1.scatter([x[1] for x in setosa_outliers], [x[2] for x in setosa_outliers], color="red")

ax2 = fig.add_subplot(332)
ax2.set_xlabel('Petal width (Virginica)')
ax2.set_ylabel('Sepal length (Virginica)')
ax2.scatter(pw_virginica, sl_virginica)
ax2.scatter([x[1] for x in virginica_outliers], [x[2] for x in virginica_outliers], color="red")

ax3 = fig.add_subplot(333)
ax3.set_xlabel('Petal width (Versicolor)')
ax3.set_ylabel('Sepal length (Versicolor)')
ax3.scatter(pw_versicolor, sl_versicolor)
ax3.scatter([x[1] for x in versicolor_outliers], [x[2] for x in versicolor_outliers], color="red")


ax4 = fig.add_subplot(334)
ax4.set_xlabel('Petal width (Setosa)')
ax4.set_ylabel('Sepal width (Setosa)')
ax4.scatter(pw_setosa, sw_setosa)
ax4.scatter([x[1] for x in setosa_outliers], [x[3] for x in setosa_outliers], color="red")

ax5 = fig.add_subplot(335)
ax5.set_xlabel('Petal width (Virginica)')
ax5.set_ylabel('Sepal width (Virginica)')
ax5.scatter(pw_virginica, sw_virginica)
ax5.scatter([x[1] for x in virginica_outliers], [x[3] for x in virginica_outliers], color="red")

ax6 = fig.add_subplot(336)
ax6.set_xlabel('Petal width (Versicolor)')
ax6.set_ylabel('Sepal width (Versicolor)')
ax6.scatter(pw_versicolor, sw_versicolor)
_ = ax6.scatter([x[1] for x in versicolor_outliers], [x[3] for x in versicolor_outliers], color="red")

ax7 = fig.add_subplot(337)
ax7.set_xlabel('Sepal length (Setosa)')
ax7.set_ylabel('Sepal width (Setosa)')
ax7.scatter(sl_setosa, sw_setosa)
ax7.scatter([x[2] for x in setosa_outliers], [x[3] for x in setosa_outliers], color="red")

ax8 = fig.add_subplot(338)
ax8.set_xlabel('Sepal length (Virginica)')
ax8.set_ylabel('Sepal width (Virginica)')
ax8.scatter(sl_virginica, sw_virginica)
ax8.scatter([x[2] for x in virginica_outliers], [x[3] for x in virginica_outliers], color="red")

ax9 = fig.add_subplot(339)
ax9.set_xlabel('Sepal length (Versicolor)')
ax9.set_ylabel('Sepal width (Versicolor)')
ax9.scatter(sl_versicolor, sw_versicolor)
_ = ax9.scatter([x[2] for x in versicolor_outliers], [x[3] for x in versicolor_outliers], color="red")

Pronalaženje elemenata izvan granica na osnovu gustine
Drugi ugao posmatranja outlier-a je analiza gustine prostora oko elementa. Ukoliko je gustina oko elementa veća, to znači da je element najverovatnije deo klastera, u suprotnom, verovatno predstavlja outlier. Otud i pristup pronalaženja outlier-a metodom klasterovanja, čiji je primer DBSCAN. Kako prostor može biti neravnomeran u pogledu gustine, klasteri mogu imati različite gustine, nije lako utvrditi prag iznad koga se element može smatrati outlier-om pa globalni metodi analize gustine nisu idealan pristup. Kao jedno od rešenja postavlja se analiza lokalne gustine, u odnosu na elemente iz bliže okoline. Primer takvog pristupa je izračunavanje LOF skora.
KNN
KNN (K-Nearest Neighbors) Algoritam za pronalaženje K najbližih suseda poznat je u domenu klasifikacije podataka. Ipak, pronalaženje najsličnijih uzoraka može se iskoristiti i za pronalaženje elemenata van granica. Intuicija za ovakav pristup rešavanju problema leži u osobini uzoraka da se uzorci koji nisu anomalije nalaze na manjim udaljenostima od svojih suseda, za razliku od uzoraka koji su van granica i čije su udaljenosti čak i od najbližih suseda primetno veće.
Algoritam pronalazi K najbližih suseda svakog uzorka i izračunava prosečnu udajenost uzorka od svojih najbližih suseda. Što je udaljenost veća, veća je verovatnoća da je uzorak anomalija.
Prednost ovog algoritma je njegova jednostavnost i činjenica da ne zahteva poznavanje raspodele podataka. Sa druge strane, iako je algoritam veoma jednostavan, vremenska složenost izvršavanja algoritma je kvadratna, što može predstavljati ograničavajući faktor za velike skupove podataka.
Implementacija uopštenog algoritma KNN za pronalaženje najbližih suseda nalazi se u biblioteci sklearn.neighbors
from sklearn.neighbors import NearestNeighbors

normal_data_with_outlier
DBSCAN
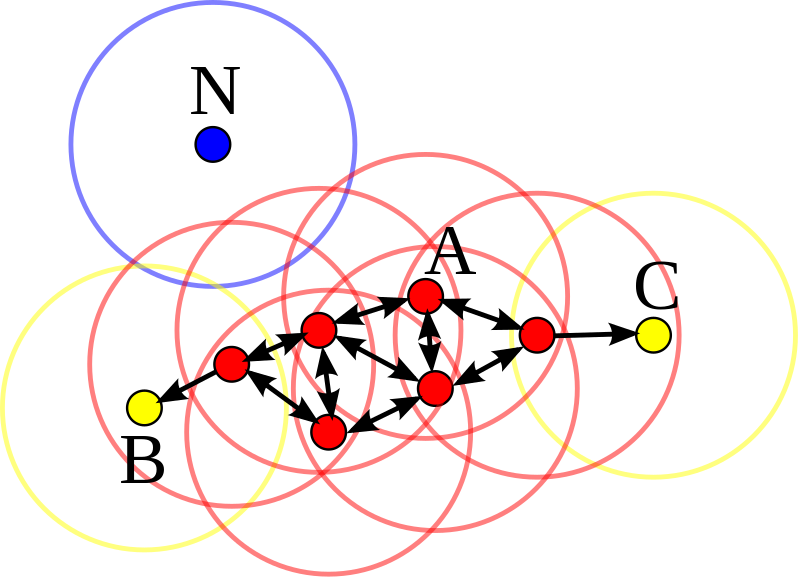
DBSCAN (Density Based Spacial Clustering of Applications with Noise) je algoritam koji vrši klasterovanje podataka na osnovu gustine prostora. Kao posledica mehanizma algoritma, pored klasterizacije, algoritam pronalazi i outlier-e.
Algoritam vrši klasifikaciju tačaka na tačke jezgra, ivične tačke i outlier-e. Klasifikacija se vrši definisanjem minimalnog broja tačaka ($minPoints$) koje je potrebno naći u okolini ($\epsilon$) tačke kako bi se tačka klasifikovala kao tačka jezgra (okolinom se smatra prostor poluprečnika $\epsilon $ oko tačke, tačka za koju se okolina se računa takođe pripada okolini, računa se u $minPoints$). Tačke koje nemaju u svojoj okolini bar $minPoints$ tačaka, ali pripadaju $\epsilon$ okolini neke tačke koja je klasifikovana kao tačka jezgra, smatraju se ivičnim tačkama i pripadaju klasteru. One tačke koje ne zadovoljavaju ni jedan od uslova smatraju se outlier-ima.
Prednosti algoritma:
- Pronalazi klastere proizvoljnih oblika i veličina
- Ne zahteva eksplicitno definisanje očekivanog broja klastera
- Dobro podnosi šum u podacima
- Može se koristiti i za numeričke i za kategoričke atribute uz adekvatan odabir funkcije udaljenosti
- Ne zahteva poznavanje raspodele podataka
Mane algoritma:
- Zasnovan na globalnoj gustini, daje loše rezultate u prostorima različitih gustina
- Osetljiv na odabir parametara, teško je odrediti idealne vrednosti
- U osnovi je zasnovan na euklidskom rastojanju što može predstavljati problem kod podataka visoke dimenzionalnosti
- U pojedinim slučajevima, svrstavanje ivične tačke više klastera u odgovarajući klaster zavisi od redosleda obilaska tačaka
Implementacija DBSCAN algoritma DBSCAN nalazi se u biblioteci sklearn.cluster
from sklearn.cluster import DBSCAN
Primer KNN
Pronalaženje elemenata van granica korišćenjem KNN algoritma
from sklearn.neighbors import NearestNeighbors

np_multidimensional_data = np.array(multidimensional_data)

knn = NearestNeighbors(n_neighbors = 3)
knn.fit(multidimensional_data)

distances, _ = knn.kneighbors()
mean_distances = np.mean(distances, axis=1)

print('Vrednosti prosecnih udaljenosti od najblizih suseda:')

# Iscrtavanje prosečnih udaljenosti
plt.plot(mean_distances)
plt.show()

# Odabrana je vrednost 40 za prag
threshold = 40

# Izdvajanje tacaka cije su prosecne udaljenosti
# od suseda vece od zadatog praga
outliers = np.where(mean_distances > threshold)[0]
print(f'Odabran prag: {threshold}')
print(f'Indeksi anomalija: {outliers}')

# print(np_multidimensional_data[:,0].ravel())

_ = plt.scatter(np_multidimensional_data[:,0], np_multidimensional_data[:,1])
_ = plt.scatter(np_multidimensional_data[outliers,0], np_multidimensional_data[outliers,1])

Primer 9.
Detekcija outlier-a korišćenjem DBSCAN algoritma
mdl = DBSCAN(eps = 20, min_samples = 3)
mdl.fit(multidimensional_data)

num_points = len(multidimensional_data)

outliers = []

for i in range(num_points):
    if mdl.labels_[i] == -1:
        outliers.append(multidimensional_data[i])

plt.scatter([x[0] for x in multidimensional_data], [x[1] for x in multidimensional_data])
_ = plt.scatter([x[0] for x in outliers], [x[1] for x in outliers])

Primer 9b.
Definisanje klastera DBSCAN algoritmom može zavisiti od redosleda obilaska tačaka prilikom klasifikovanja kao tačke jezgra, ivične ili outlier-e.
data_points = [[1,2],[2,1],[2,3],[2,2], [3,2], [4,2],[4,1],[4,3],[5,2]]

mdl = DBSCAN(eps = 1, min_samples = 4)
mdl.fit(data_points)

num_points = len(data_points)

outliers = []

cluster_1 = []
cluster_2 = []

for i in range(num_points):
    if mdl.labels_[i] == -1:
        outliers.append(data_points[i])
    elif mdl.labels_[i] == 0:
        cluster_1.append(data_points[i])
    else:
        cluster_2.append(data_points[i])

plt.scatter([x[0] for x in data_points], [x[1] for x in data_points])
_ = plt.scatter([x[0] for x in outliers], [x[1] for x in outliers])
_ = plt.scatter([x[0] for x in cluster_1], [x[1] for x in cluster_1])
_ = plt.scatter([x[0] for x in cluster_2], [x[1] for x in cluster_2])

data_points = [[3,2], [4,2],[4,1],[4,3],[5,2], [1,2],[2,1],[2,3],[2,2]] # Obrnut redosled

mdl = DBSCAN(eps = 1, min_samples = 4)
mdl.fit(data_points)

num_points = len(data_points)

outliers = []

cluster_1 = []
cluster_2 = []

for i in range(num_points):
    if mdl.labels_[i] == -1:
        outliers.append(data_points[i])
    elif mdl.labels_[i] == 0:
        cluster_1.append(data_points[i])
    else:
        cluster_2.append(data_points[i])

plt.scatter([x[0] for x in data_points], [x[1] for x in data_points])
_ = plt.scatter([x[0] for x in outliers], [x[1] for x in outliers])
_ = plt.scatter([x[0] for x in cluster_1], [x[1] for x in cluster_1])
_ = plt.scatter([x[0] for x in cluster_2], [x[1] for x in cluster_2])

LOF skor
LOF skor (Local Outlier Factor) predstavlja još jedan pristup pronalaženja outlier-a iz ugla gustine. Prag gustine prostora nije definisan globalnim parametrima, kao što je slučaj kod DBSCAN, već se analiza vrši lokalno, u odnosu na okolinu tačke. Tačke oko kojih je gustina niža od prosečne gustini prostora oko susednih tačaka smatra se outlier-om.
Računanje LOF zahteva izračunavanje par pomoćnih vrednosti:
- $Kdistance$ - Udaljenost tačke od k-tog najbližeg suseda
- $N_k$ - Skup k-najbližih suseda
- $|N_k|$ - Broj tačaka među k-najbližih suseda (u slučaju da se dve tačke nalaze na istoj udaljenosti, obe tačke se smatraju kao jedna i iz tog razloga je moguće da $|N_k|$ bude vrednost veća od $k$)
- $RD_k$ - (Reachability Distance) za k najbližih suseda (stvarna udaljenost između A i B sa donjim pragom udaljenosti B do svog k-tog najbližeg suseda; tumači se kao udaljenost od suseda B do A) $$RD_k(A,B) = max\{d(A,B), Kdistance(B)\}$$
- $LRD_k$ - (Local Reachability Density) za k najbližih suseda (lokalna gustina izražena kao inverz prosečne udaljenosti k-najbližih suseda od tačke) $$LRD_k(A) = (\frac{\sum_{i = 1}^{|N_k(A)|}{RD_k(A, N_k(A)[i])}}{|N_k(A)|})^{-1}$$
- $LOF$ (Local Outlier Factor) - Prosečni odnos gustina tačke od gustina tačaka iz okoline $$LOF(A) = \frac{\sum_{i = 1}^{|N_k(A)|}{\frac{LRD_k(N_k(A)[i])}{LRD_k(A)}}}{|Nk(A)|}$$
Klasifikacija tačke kao outlier zavisi od vrednosti LOF skora:
- LOF < 1 - Gustina okoline tačke je veća od gustine okolnih tačaka pa predstavlja jezgro klastera
- LOF = 1 - Gustina okoline tačke je jednaka gustini okolnih tačaka pa predstavlja deo klastera
- LOF > 1 - Gustina okoline tačke je manja od gustine okolnih tačaka pa verovatno predstavlja outlier

Prednosti algoritma:
- Vrši izračunavanja u odnosu na lokalnu gustinu
- Dobra teorijska zasnovanost vrednosti praga
Prednosti algoritma:
- Vremenska efikasnost usled velikog broja pronalaženja najbližih suseda (postoje optimizacije)
- Granična vrednost 1 nije najbolji prag u slučaju podataka sa velikom količinom šuma
Implementacija LOF algoritma LocalOutlierFactor nalazi se u biblioteci sklearn.neighbors
from sklearn.neighbors import LocalOutlierFactor
Primer 10.
Pronalaženje outlier-a pomoću LOF skora
clf = LocalOutlierFactor(n_neighbors=20, contamination=0.1)
labels = clf.fit_predict(multidimensional_data)

num_points = len(multidimensional_data)

outliers = []

for i in range(num_points):
    if labels[i] == -1:
        outliers.append(multidimensional_data[i])

plt.scatter([x[0] for x in multidimensional_data], [x[1] for x in multidimensional_data])
_ = plt.scatter([x[0] for x in outliers], [x[1] for x in outliers])
Pronalaženje elemenata izvan granica na osnovu separabilnosti
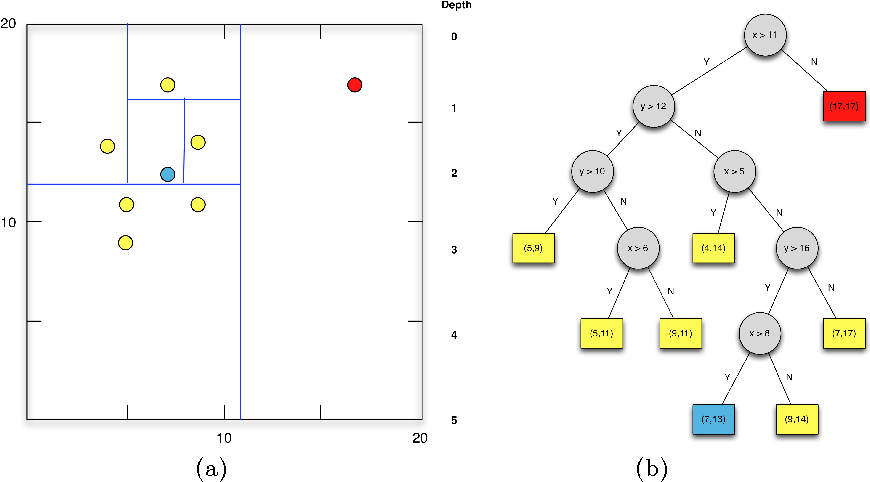
Još jedan ugao iz kog se mogu posmatrati elementi izvan granica je osobina separabilnosti. Elementi izvan granica se lakše (korišćenjem manjeg broja uslova, jednostavnijih funkcija, ...) mogu razdvojiti od ostalih elemenata, u odnosu na elemente koji pripadaju klasterima. Jedan od algoritama koji uzima ovo svojstvo u obzir je Isolation Forest koji po proizvoljno odabranom atributu deli skup na dva dela proizvoljnom pravom i postupak ponavlja sve dok sve instance nisu izolovane od ostalih. Ideja algoritma je da se elementi koji su izvan granica mogu izdvojiti u manjem broju iteracija u odnosu na regularne elemente. Jedna od karakteristika ovog algoritma je da cilj nije formiranje klastera i označavanje preostalih elemenata za outlier-e, već obrnuto, cilj direktno pronalaženje outlier-a.
Početno stanje podrazumeva čvor koji sadrži sve elemente skupa. Svakom iteracijom skup se proizvoljnom pravom deli na dva skupa i time stablo dobija dva nova čvora. Dužina puta od korena (celog skupa) do lista koji sadrži samo jednu instancu koristi se kao mera (inverz) anomalije elementa koji se nalazi u listu. Što je put kraći, veća je verovatnoća da je element outlier. Postupak formiranja takvih stabla se ponavlja više puta i izračunava se prosečna dužina puteva. Dobijena vrednost predstavlja prag dužine ispod kog se element smatra outlier-om. Svaki od elemenata dobija skor kao prosečna vrednost skorova u svakom od stabala.
Prednosti algoritma:
- Ne zahteva poznavanje raspodele podataka
- Ne zahteva skaliranje podataka
- Mali broj parametara
- Robusnost
Mane algoritma:
- Vremenska složenost
Implementacija algoritma IsolationForest nalazi se u biblioteci sklearn.ensemble
from sklearn.ensemble import IsolationForest
Primer 11.
Pronalaženje elemenata izvan granica korišćenjem Isolation Forest algoritma
mdl = IsolationForest(n_estimators=100, contamination=0.1, behaviour="new")
labels = mdl.fit_predict(multidimensional_data)
num_points = len(multidimensional_data)

outliers = []

for i in range(num_points):
    if labels[i] == -1:
        outliers.append(multidimensional_data[i])

plt.scatter([x[0] for x in multidimensional_data], [x[1] for x in multidimensional_data])
_ = plt.scatter([x[0] for x in outliers], [x[1] for x in outliers])
